
计算机与人工智能
熵减的艺术:从统计物理到模拟退火算法的数学原理与实践
文章目录
在计算机科学的广袤领域中,最优雅的算法往往并非诞生于纯粹的逻辑推演,而是源于对自然界深刻规律的模仿。从神经网络模仿大脑皮层,到蚁群算法模仿昆虫社会,仿生学一直是算法创新的源泉。然而,在这些受生物学启发的算法出现之前,物理学早已为我们提供了一种解决复杂组合优化问题的强大思想工具。
这就是模拟退火算法(Simulated Annealing, SA)。
不仅仅是一个寻找最优解的工具,模拟退火算法是统计物理与组合优化之间的一座桥梁。它揭示了物质微观状态的能量演化与宏观决策优化之间惊人的同构性。本文将带您回到1953年和1983年,从热力学的第一性原理出发,剖析这一算法的数学本质。
第一部分:物理学起源——退火与热力学
要理解模拟退火,我们首先必须理解“退火”(Annealing)这一冶金学概念的物理本质。
1.1 晶体结构与内能
在凝聚态物理中,固体的内部结构取决于其粒子的排列方式。一个完美的晶体结构通常对应着系统的最低能量状态(基态)。然而,如果在材料加工过程中,熔融的金属被快速冷却(淬火),粒子将来不及有序排列,从而被“冻结”在一种高能量的非晶体或多晶体状态。这种状态内部存在巨大的应力,且极其不稳定。
为了消除这种缺陷,工匠们发明了退火工艺: 1. 加热(Heating): 将固体加热至高温,使粒子获得足够的热运动能量,从而打破原有的固定位置,变为无序的液态或高能态。 2. 等温(Isothermal): 保持温度,使系统达到热平衡。 3. 冷却(Cooling): 极度缓慢地降低温度。
在缓慢冷却的过程中,粒子有足够的时间通过热运动探索各种可能的排列位置。随着温度降低,系统倾向于停留在能量较低的状态。如果冷却速度足够慢,根据热力学原理,粒子最终将排列成能量最低的完美晶体结构。
1.2 玻尔兹曼分布与统计力学
物理学家路德维希·玻尔兹曼(Ludwig Boltzmann)为上述过程提供了数学描述。在热平衡状态下,一个系统处于能量状态 \(E\) 的概率 \(P(E)\) 服从玻尔兹曼分布(Boltzmann Distribution):
其中: * \(E\) 是系统的能量。 * \(T\) 是绝对温度。 * \(k_B\) 是玻尔兹曼常数。
这个公式不仅是统计物理的基石,也是模拟退火算法的灵魂。它告诉我们两个关键事实: 1. 低能态概率更高: 在任何温度下,系统处于低能量状态的概率总是高于高能量状态。 2. 温度决定随机性: * 当 \(T \to \infty\) 时,\(e^{-\frac{E}{k_B T}} \to 1\),意味着处于任何能量状态的概率几乎相等。系统处于极度混乱的随机游走状态。 * 当 \(T \to 0\) 时,如果 \(E > E_{min}\),则概率趋近于0。系统不仅倾向于低能态,而且几乎被强行锁定在最低能态。
第二部分:从物理到算法——Metropolis-Hastings 算法
1953年,Nicholas Metropolis 等人在这一物理背景下提出了著名的 Metropolis 算法,用于模拟固体在热浴中的平衡态。这也是最早的蒙特卡洛方法之一。
2.1 Metropolis 准则
Metropolis 算法的核心在于如何模拟粒子状态的转移。假设系统当前处于状态 \(i\),能量为 \(E_i\),我们试图将其扰动到新状态 \(j\),能量为 \(E_j\)。定义能量差为:
系统接受从 \(i\) 到 \(j\) 转移的概率 \(P_{accept}\) 定义为:
这里蕴含了极为深刻的哲学思想:
- 贪婪(Greedy)的一面: 如果新状态能量更低(\(\Delta E < 0\)),我们百分之百接受它。这保证了系统有向最优解进化的趋势。
- 宽容(Stochastic)的一面: 如果新状态能量更高(\(\Delta E \geq 0\)),通常的优化算法(如梯度下降)会直接拒绝。但在 Metropolis 准则中,我们以一定的概率接受这个更差的状态。
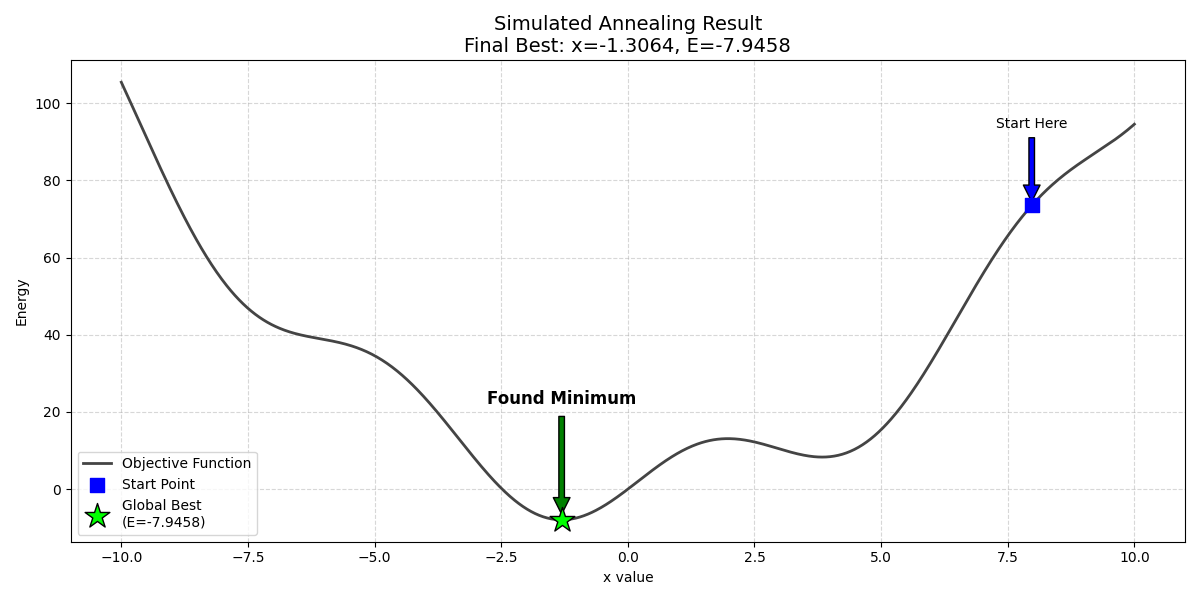
为什么要接受更差的状态?这是为了跳出局部最优解(Local Optima)。在优化景观中,局部最优解就像一个个深坑。如果我们只允许能量降低,一旦落入坑底(局部极小值),就再也爬不出来了。Metropolis 准则允许系统偶尔“爬坡”,从而有机会跨越山脊,探索到更深的山谷(全局最优解)。
第三部分:模拟退火算法的数学建模
1983年,Kirkpatrick, Gelatt 和 Vecchi 在《Science》上发表了划时代的论文 Optimization by Simulated Annealing,正式将热力学退火思想引入组合优化领域。
3.1 核心映射
为了将物理过程转化为算法,我们需要建立以下映射关系:
| 物理学概念 | 组合优化概念 |
|---|---|
| 系统状态 (State) | 可行解 (Solution) |
| 能量 (Energy) | 目标函数/成本函数 (Cost Function, \(f(x)\)) |
| 基态 (Ground State) | 全局最优解 (Global Optimum) |
| 温度 (Temperature) | 控制参数 (Control Parameter, \(T\)) |
| 快速淬火 (Quenching) | 局部搜索/贪婪算法 (Local Search) |
3.2 算法流程
模拟退火算法本质上是一个非齐次马尔可夫链(Inhomogeneous Markov Chain)过程。其标准流程如下:
-
初始化: * 设定初始温度 \(T_0\)(须足够高)。
- 随机生成初始解 \(x_0\)。
- 计算初始目标函数值 \(E(x_0)\)。
-
外循环(降温过程): 当 \(T > T_{min}\) 时,执行以下步骤:
-
内循环(等温过程): 在当前温度 \(T\) 下,重复 \(L\) 次(或直至达到平衡):
a. 扰动产生新解: 在当前解 \(x\) 的邻域内产生新解 \(x'\)。
b. 计算增量: \(\Delta E = E(x') - E(x)\)。
c. 接受判别: 生成一个 \([0, 1]\) 之间的随机数 \(r\)。 如果 \(\Delta E < 0\) 或者 \(e^{-\frac{\Delta E}{T}} > r\),则接受 \(x'\) 作为当前解:\(x \leftarrow x'\)。 否则,保持原解 \(x\) 不变。
-
降温: 按照预定的冷却进度表(Cooling Schedule)降低温度,\(T \leftarrow \alpha T\)(通常 \(\alpha \in [0.8, 0.99]\))。
-
-
终止: 输出最终解。
3.3 关键参数详解
A. 初始温度 \(T_0\)
初始温度必须足够高,以保证在算法初期,\(e^{-\frac{\Delta E}{T_0}} \approx 1\)。这意味着算法在开始阶段几乎接受所有移动,不论好坏。这对应于物理上的液体状态,系统可以在解空间中自由遍历,不受局部地形的限制。如果 \(T_0\) 过低,算法将退化为简单的局部搜索。
B. 邻域结构 (Neighborhood Structure)
如何产生新解 \(x'\) 是算法效率的关键。对于离散问题(如TSP),常见的操作包括: * Swap: 交换序列中两个城市的位置。 * Reversion: 将序列中一段子序列逆序。 * Insertion: 将一个元素取出插入到另一个位置。
C. 冷却进度表 (Cooling Schedule)
这是模拟退火中最具“艺术性”的部分。 * 指数降温(最常用): \(T_{k+1} = \alpha T_k\)。衰减系数 \(\alpha\) 越接近1,降温越慢,找到全局最优的概率越大,但计算时间越长。 * 对数降温: \(T_k = \frac{C}{\ln(1+k)}\)。数学上证明了对数降温是保证算法收敛到全局最优的充分条件(Geman & Geman, 1984)。然而,这种降温速度在工程上实在太慢,通常被认为是不可接受的。
第四部分:马尔可夫链与收敛性分析
为什么模拟退火能工作?这不仅仅是直觉,更有严格的数学保障。
在每一个固定的温度 \(T\) 下,接受准则定义了一个马尔可夫链的转移概率矩阵。Metropolis 准则构造的转移概率满足细致平衡条件(Detailed Balance Condition):
这意味着在温度 \(T\) 固定时,马尔可夫链的平稳分布正是玻尔兹曼分布:
其中 \(Z(T)\) 是配分函数(Partition Function),用于归一化。
随着 \(T \to 0\),玻尔兹曼分布 \(\pi_T(x)\) 将逐渐集中在能量最小的那些状态上。当 \(T\) 趋近于 0 时,分布将收敛于定义在全局最优解集合上的均匀分布。
理论上的保证: 如果降温过程足够慢(如对数降温),且在每个温度下都达到热平衡,那么模拟退火算法以概率 1 收敛于全局最优解。
工程上的妥协: 实际应用中,我们无法等待无限长的时间。因此,我们通常使用指数降温等更快的策略。这意味着我们牺牲了“保证找到全局最优”的理论确定性,换取了“在可接受时间内找到足够好解”的工程实用性。
第五部分:应用与比较
5.1 经典案例:旅行商问题 (TSP)
在 TSP 问题中,目标是寻找一条经过所有城市并回到原点的最短路径。这是一个经典的 NP-hard 问题。 使用模拟退火解决 TSP 时: * 状态: 城市的排列顺序。 * 能量: 路径的总长度。 * 操作: 随机交换两个城市或翻转一段路径。
在高温阶段,路径可能会变得混乱且交叉(高能量),但这允许算法调整大范围的拓扑结构。随着温度降低,路径逐渐解开交叉,变得平滑,最终收敛到最短路径。
5.2 模拟退火 vs. 其他算法
-
对比梯度下降 (Gradient Descent): 梯度下降是决定性的,只走向下走。它收敛快,但极易陷入局部最优。模拟退火引入了随机性(熵),通过“犯错”来避免短视。
-
对比遗传算法 (Genetic Algorithms): 遗传算法是基于种群的(Population-based),通过杂交和变异进化。模拟退火通常是基于单点的(Trajectory-based)。遗传算法擅长在解空间中进行大范围的并行搜索,而模拟退火在精细挖掘和参数控制上往往更具理论深度。
5.3 优缺点总结
优点: * 通用性强: 对目标函数的性质(如连续性、可导性)无要求。 * 全局优化: 理论上能跳出局部最优。 * 实现简单: 核心代码往往只有几十行。
缺点: * 参数敏感: 初始温度、冷却速率、马尔可夫链长度等参数对结果影响巨大,往往需要通过实验调整(调参是玄学)。 * 收敛速度慢: 为了获得高质量的解,通常需要大量的迭代步数,计算成本高。
第六部分:总结与展望
模拟退火算法是人类智慧的结晶,它向我们展示了如何通过模仿自然的物理过程来解决复杂的人工问题。从无序到有序,从高能到低能,退火过程本质上是一个熵减的过程。
在人工智能日益发展的今天,虽然深度学习占据了舞台中央,但在离散优化、芯片布局布线、物流调度等领域,模拟退火及其变种(如量子退火)依然发挥着不可替代的作用。它提醒我们,在追求最优解的道路上,偶尔的退步(接受差解)不仅是允许的,往往更是达到巅峰所必须的。
正如生活中的智慧:为了长远的进步,我们必须学会容忍暂时的挫折。
CONTINUE EXPLORING
DISCUSSION
留言与讨论
分享你的理解,或留下一个值得继续讨论的问题。
还没有留言,欢迎成为第一个参与讨论的人。