
计算机与人工智能
拟牛顿法的巅峰:BFGS 算法详解与 Python 从零实现
文章目录
在优化算法的家族谱系中,BFGS 处于一个微妙而完美的平衡点。
- 梯度下降 (Gradient Descent) 像是一个登山者,只看脚下的坡度,低头猛冲,容易陷入震荡。
- 牛顿法 (Newton's Method) 像是一个拥有上帝视角的测绘师,它能看到地形的曲率(二阶导数),一步到位。但是,计算海森矩阵(Hessian Matrix)及其逆矩阵的代价是极其高昂的(\(O(N^3)\))。
BFGS 的核心哲学是:如果你走过的路足够多,你就能通过脚下的变化推测出地形的全貌,而不需要上帝视角。
本文将深入解构 BFGS 算法的数学原理,并从零编写一个 Python 实现。
一、 第一性原理:从割线方程出发
1.1 回顾牛顿法
为了求目标函数 \(f(x)\) 的极小值,牛顿法的更新公式为:
其中 \(H_k = \nabla^2 f(x_k)\) 是海森矩阵。我们的目标是找到一个矩阵 \(B_k\) 来近似 \(H_k\),或者更直接地,找到一个矩阵 \(D_k\) 来近似 \(H_k^{-1}\),从而避免求逆运算。BFGS 选择直接逼近逆矩阵 \(H^{-1}\)。为了符合通用教材符号,下文中我们用 \(H_k\) 表示海森矩阵的逆矩阵近似(Inverse Hessian Approximation)。
即更新方向为:\(p_k = -H_k \nabla f(x_k)\)。
1.2 割线方程 (The Secant Equation)
BFGS 的基石在于割线条件。
我们考察第 \(k\) 步到第 \(k+1\) 步的变化: * 位置变化:\(s_k = x_{k+1} - x_k\) * 梯度变化:\(y_k = \nabla f(x_{k+1}) - \nabla f(x_k)\)
在二次函数的假设下(或者对 \(f(x)\) 在 \(x_{k+1}\) 处进行二阶泰勒展开),梯度之间的关系满足:
移项得到 \(y_k \approx \nabla^2 f \cdot s_k\)。因为 \(H_{k+1}\) 是我们要维护的逆海森矩阵近似,所以我们要求 \(H_{k+1}\) 满足:
这就是著名的拟牛顿条件(或者叫割线方程)。任何拟牛顿法都必须满足这个方程。它告诉我们:新的矩阵必须能够正确映射这一步的梯度变化到位移变化。
1.3 秩二更新 (Rank-Two Update)
满足割线方程的矩阵 \(H_{k+1}\) 有无穷多个。BFGS 的天才之处在于它选择“距离”上一步 \(H_k\) 最近的那个矩阵。
这是一个带约束的优化问题(利用 Frobenius 范数):
经过复杂的数学推导(此处省略拉格朗日乘数法的冗长过程),我们得到了著名的 BFGS 更新公式。这个公式是一个秩二更新(Rank-Two Update),意味着我们通过加上两个秩为 1 的矩阵来修正 \(H_k\):
其中标量 \(\rho_k = \frac{1}{y_k^T s_k}\)。
物理意义: 这个公式本质上是在不断“扭曲”空间。初始时,\(H_0\) 通常设为单位矩阵 \(I\)(此时第一步等同于梯度下降)。随着迭代进行,\(H_k\) 逐渐吸收了地形的曲率信息,变形为真实的逆海森矩阵,使得优化路径从“之”字形变为直指靶心的直线。
二、 算法完整流程
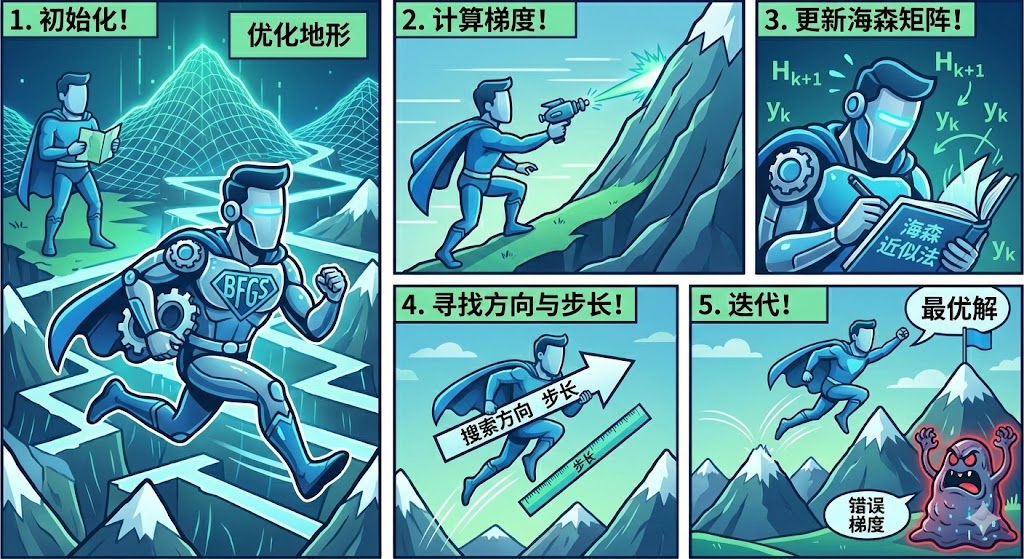
BFGS 的每一次迭代包含以下四个核心步骤:
- 计算方向:利用当前的逆海森近似矩阵计算下降方向:\(p_k = -H_k \nabla f(x_k)\)。
- 线搜索 (Line Search):在方向 \(p_k\) 上寻找合适的步长 \(\alpha_k\),使得 \(x_{k+1} = x_k + \alpha_k p_k\) 满足Wolfe 条件(保证函数值充分下降且曲率满足要求)。
- 计算差值:计算 \(s_k = x_{k+1} - x_k\) 和 \(y_k = \nabla f(x_{k+1}) - \nabla f(x_k)\)。
- 矩阵更新:利用 BFGS 公式更新 \(H_k \to H_{k+1}\)。
三、 Python 代码实现
为了彻底理解,我们将不使用 scipy.optimize,而是仅使用 numpy 实现 BFGS。我们将使用经典的 Rosenbrock 函数(香蕉函数)作为测试场,这是一个著名的非凸优化难题,拥有一个狭长的抛物线山谷。
3.1 目标函数与梯度
import numpy as np

def rosenbrock(x):
    """
    Rosenbrock 函数: f(x,y) = (a-x)^2 + b(y-x^2)^2
    通常 a=1, b=100. 全局最小值为 0,在 (1, 1) 处。
    """
    return (1 - x[0])**2 + 100 * (x[1] - x[0]**2)**2

def rosenbrock_grad(x):
    """
    Rosenbrock 函数的梯度
    """
    grad = np.zeros_like(x)
    grad[0] = -2 * (1 - x[0]) - 400 * x[0] * (x[1] - x[0]**2)
    grad[1] = 200 * (x[1] - x[0]**2)
    return grad
3.2 简单的回溯线搜索 (Backtracking Line Search)
在工业级实现中(如 L-BFGS-B),通常使用满足强 Wolfe 条件的线搜索。为了代码清晰,这里实现一个满足 Armijo 条件(充分下降条件)的回溯线搜索。
def backtracking_line_search(f, grad_f, x, p, alpha=1.0, rho=0.5, c=1e-4):
    """
    寻找步长 alpha,使得 f(x + alpha * p) <= f(x) + c * alpha * grad_f(x)^T * p
    """
    f_val = f(x)
    grad_dot_p = np.dot(grad_f(x), p)

    while f(x + alpha * p) > f_val + c * alpha * grad_dot_p:
        alpha *= rho  # 步长减半
        if alpha < 1e-16: # 防止死循环
            break
    return alpha
3.3 BFGS 核心逻辑实现
这是魔法发生的地方。请注意观察 H_new 的更新公式是如何直接翻译数学公式的。
def bfgs_optimize(f, grad_f, x0, max_iter=100, tol=1e-5):
    """
    BFGS 优化算法主函数
    """
    x = np.array(x0, dtype=float)
    n = len(x)

    # 初始化逆海森矩阵近似 H 为单位矩阵
    # 此时第一步相当于梯度下降
    H = np.eye(n)

    path = [x.copy()] # 记录路径用于可视化

    for k in range(max_iter):
        g = grad_f(x)

        # 0. 检查收敛 (梯度范数)
        g_norm = np.linalg.norm(g)
        if g_norm < tol:
            print(f"Converged at iteration {k}, Gradient Norm: {g_norm:.6f}")
            break

        # 1. 计算搜索方向 p = -H * g
        p = -np.dot(H, g)

        # 2. 线搜索确定步长 alpha
        alpha = backtracking_line_search(f, grad_f, x, p)

        # 3. 更新位置
        x_new = x + alpha * p
        s = x_new - x
        y = grad_f(x_new) - g

        # 4. BFGS 矩阵更新
        # 注意: 必须保证 y^T * s > 0 (曲率条件),否则无法保证正定性,应跳过更新
        rho_inv = np.dot(y, s)

        if rho_inv > 1e-10: # 数值稳定性检查
            rho = 1.0 / rho_inv
            I = np.eye(n)

            # 为了代码可读性,分步计算公式:
            # H_{k+1} = (I - rho s y^T) H (I - rho y s^T) + rho s s^T

            term1 = I - rho * np.outer(s, y)
            term2 = I - rho * np.outer(y, s)
            term3 = rho * np.outer(s, s)

            H = np.dot(term1, np.dot(H, term2)) + term3

        x = x_new
        path.append(x.copy())

        if k % 10 == 0:
            print(f"Iter {k}: f(x) = {f(x):.6f}, x = {x}")

    return x, np.array(path)

# --- 运行测试 ---
if __name__ == "__main__":
    start_point = [-1.2, 1.0] # Rosenbrock 的经典起始点
    opt_x, path = bfgs_optimize(rosenbrock, rosenbrock_grad, start_point)

    print("\nOptimization Result:")
    print(f"Solution: {opt_x}")
    print(f"True Min: [1.0, 1.0]")
四、 为什么 BFGS 优于梯度下降?
当你运行上述代码时,你会发现 BFGS 能够在 30-40 次迭代内收敛到 (1.0, 1.0)。作为对比,如果使用普通梯度下降(即使带有动量),在这个起点往往需要几千次迭代才能走出 Rosenbrock 函数平坦的山谷。
关键差异在于 \(H\) 矩阵: * 在峡谷中,垂直于谷底方向的梯度很大,沿谷底方向的梯度很小。 * 梯度下降会被大梯度主导,在峡谷壁之间来回震荡。 * BFGS 的矩阵 \(H\) 会“学习”到这个峡谷的形状(Condition Number),自动缩放各个方向的步长——抑制震荡方向,加速平坦方向。
五、 局限性与 L-BFGS
BFGS 有一个致命弱点:内存消耗。
如果参数量 \(N=1,000,000\)(这在深度学习中很常见),存储 \(N \times N\) 的矩阵 \(H\) 需要 \(10^{12}\) 个浮点数,相当于数 TB 的内存。
这就是 L-BFGS (Limited-memory BFGS) 诞生的原因。L-BFGS 并不显式存储矩阵 \(H\),而是存储最近 \(m\) 步(通常 \(m=10\))的 \(s_k\) 和 \(y_k\) 向量。当需要计算 \(H \cdot g\) 时,利用双循环递归算法(Two-loop recursion)动态还原出矩阵向量积。这使得空间复杂度从 \(O(N^2)\) 骤降为 \(O(mN)\),也就是 \(O(N)\)。
结语
BFGS 算法是数学美感的典范。它没有粗暴地丢弃历史信息,也没有奢求全知全能的二阶导数,而是在“无知”与“全知”之间,通过迭代的逼近找到了一条最优路径。
掌握 BFGS,不仅是掌握了一种算法,更是理解了**曲率(Curvature)**在优化问题中那决定性的力量。
Would you like to see how to implement the L-BFGS version to handle larger scale problems, or dive into the mathematical proof of why BFGS maintains the positive definiteness of the matrix?
CONTINUE EXPLORING
DISCUSSION
留言与讨论
分享你的理解,或留下一个值得继续讨论的问题。
还没有留言,欢迎成为第一个参与讨论的人。