
计算机与人工智能
超越梯度下降:经典优化算法的深度解析与第一性原理
文章目录
在当今的深度学习热潮中,我们往往沉迷于 SGD 及其变种(Adam, AdaGrad 等)在非凸优化曲面上的炼金术。然而,优化理论的大厦并非建立在这些现代启发式方法之上。要真正理解“优化”二字的重量,我们需要回溯历史,去探寻那些由柯西(Cauchy)、牛顿(Newton)、拉格朗日(Lagrange)以及统计物理学家们铺就的基石。
优化的本质是什么?在物理学中,它是能量最低原理(The Principle of Minimum Energy);在经济学中,它是效用最大化(Utility Maximization);在数学中,它是寻找流形上的驻点。
本文将剥离现代框架的层层封装,从第一性原理(First Principles)出发,重新审视那些值得我们终身学习的经典优化算法。
一、 二阶法的王冠:牛顿法 (Newton's Method)
如果说梯度下降(Gradient Descent)是在迷雾中沿着坡度摸索,那么牛顿法就是拥有了上帝视角,试图看清地形的曲率。
1.1 第一性原理:泰勒级数的二次近似
梯度下降利用的是目标函数的一阶泰勒展开(线性近似),而牛顿法则利用了二阶泰勒展开(二次近似)。
假设我们要最小化函数 \(f(x)\)。在点 \(x_k\) 附近,我们不仅关心“往哪走下降最快”(梯度 \(\nabla f(x_k)\)),还关心“地形弯曲得有多厉害”(海森矩阵 Hessian Matrix, \(\nabla^2 f(x_k)\))。
我们将 \(f(x)\) 在 \(x_k\) 处进行二阶泰勒展开:
其中 \(H_k = \nabla^2 f(x_k)\) 是海森矩阵。为了找到这个二次近似函数的极小值点,我们对其求导并令其为 0:
解出 \(x\),我们得到牛顿法的更新公式:
1.2 几何意义与物理直觉
- 几何上:梯度下降是用一个平面去切曲面,而牛顿法是用一个抛物面(Paraboloid)去拟合曲面。如果目标函数本身就是二次的(Quadrtic),牛顿法一步就能收敛。
- 物理上:海森矩阵对应着物理系统中的“刚度矩阵”。梯度对应力,海森矩阵对应弹簧常数。\(F = kx \implies x = F/k\),这正是 \(x \sim \nabla f / H\) 的物理原型。
1.3 为什么它值得学习?
尽管在深度学习中,计算海森矩阵的逆 \(H^{-1}\) 极其昂贵(\(O(n^3)\)),但在参数量较小的科学计算、控制理论(Control Theory)和传统的统计机器学习中,牛顿法的二次收敛速度(Quadratic Convergence)是无与伦比的。它教会我们:曲率信息(Curvature)是加速收敛的关键。
二、 拟牛顿法:计算效率的妥协 (Quasi-Newton Methods / BFGS)
既然计算 \(H^{-1}\) 太慢,能不能去近似它?这就引出了拟牛顿法(Quasi-Newton Methods)。其中最著名的当属 BFGS 算法(Broyden–Fletcher–Goldfarb–Shanno)。
2.1 割线方程 (The Secant Equation)
我们希望在不计算二阶导数的情况下,通过一阶导数的变化量来推断二阶导数的信息。这就好比在一维情况下,用割线斜率近似切线斜率。
定义: * 位移变化量:\(s_k = x_{k+1} - x_k\) * 梯度变化量:\(y_k = \nabla f(x_{k+1}) - \nabla f(x_k)\)
根据中值定理或泰勒展开,我们有 \(y_k \approx H_{k+1} s_k\)。这就是著名的割线方程。
2.2 BFGS 的精妙之处
BFGS 算法的核心在于迭代地更新海森矩阵的逆近似 \(B_k \approx H_k^{-1}\)。它必须满足两个条件: 1. 满足割线方程。 2. 保持 \(B_k\) 的对称正定性(Symmetric Positive Definite),确保优化方向始终是下降方向。
BFGS 的更新公式虽然复杂,但它体现了数学上的极致权衡:用秩二更新(Rank-Two Update)在保留历史曲率信息的同时,将计算复杂度从 \(O(n^3)\) 降到了 \(O(n^2)\)。
def bfgs_update(B, s, y):
    """
    简化的 BFGS 更新逻辑演示
    B: 当前 Hessian 逆的近似
    s: 位移向量 (x_new - x_old)
    y: 梯度差向量 (grad_new - grad_old)
    """
    rho = 1.0 / (y.T @ s)
    I = np.eye(len(s))

    # 经典的 BFGS 更新公式
    V = I - rho * (s @ y.T)
    B_new = V @ B @ V.T + rho * (s @ s.T)

    return B_new
对于大规模问题,L-BFGS(Limited-memory BFGS)进一步通过只存储最近 \(m\) 步的向量来隐式构建 \(B_k\),将空间复杂度降为 \(O(n)\)。这是工业界(如 CTR 预估、大规模逻辑回归)最强大的兵器之一。
三、 共轭梯度法:正交的艺术 (Conjugate Gradient)
如果我们面对的是一个巨大的正定二次型问题(比如求解 \(Ax=b\),等价于最小化 \(\frac{1}{2}x^TAx - b^Tx\)),梯度下降往往会在狭长的山谷中震荡(Zig-zagging)。
3.1 为什么要“共轭”?
普通梯度下降的问题在于,我们在一个方向上优化完之后,随后的步骤可能会破坏之前方向上的优化成果。
共轭梯度法(CG)提出并通过了一个天才的想法:让我们的一步走得足够“精准”,保证在这个方向上永远不需要再次优化。
这需要我们选取的搜索方向 \(p_0, p_1, \dots\) 对于矩阵 \(A\) 是共轭的(Conjugate),即:
这是一种广义的“正交”。在共轭方向上进行线性搜索(Line Search),可以保证在 \(n\) 步之内(对于 \(n\) 维问题)精确收敛到全局最优解。
3.2 克雷洛夫子空间 (Krylov Subspace)
从更高深的线性代数视角来看,CG 实际上是在克雷洛夫子空间 \(\mathcal{K}_n(A, b) = \text{span}\{b, Ab, A^2b, \dots, A^{n-1}b\}\) 中寻找最优解。这一视角将优化算法与矩阵分析深刻地联系在了一起。
四、 对偶理论与拉格朗日乘数 (Duality & Lagrange Multipliers)
当优化问题遇到了约束(Constraints),单纯的“下山”就不够了。我们不仅要低头看路,还要看有没有撞到墙。
4.1 经济学视角:影子价格
考虑带约束问题:
拉格朗日函数为 \(L(x, \lambda) = f(x) + \lambda g(x)\)。
这里的 \(\lambda\)(拉格朗日乘子)不仅是一个数学辅助变量,它有着深刻的经济学含义——影子价格(Shadow Price)。它代表了约束条件的“边际成本”。如果你稍微放松一点约束(让 \(g(x) = \epsilon\)),目标函数 \(f(x)\) 会下降多少?答案正是 \(\lambda\)。
4.2 KKT 条件与对偶性
对于不等式约束 \(g(x) \le 0\),我们引入了 KKT 条件(Karush-Kuhn-Tucker conditions)。其中最迷人的是互补松弛性(Complementary Slackness):
这意味着:要么约束不起作用(\(g_i(x) < 0\),此时 \(\lambda_i = 0\),资源不稀缺,价格为0);要么约束紧绷(\(g_i(x) = 0\),此时 \(\lambda_i > 0\),资源稀缺,价格为正)。
通过拉格朗日对偶(Lagrange Duality),我们可以将一个棘手的原问题(Primal Problem)转化为一个可能更容易求解的对偶问题(Dual Problem)。支持向量机(SVM)的巨大成功,正是建立在凸优化与强对偶性的坚实地基之上。
五、 模拟退火:来自统计物理的启示 (Simulated Annealing)
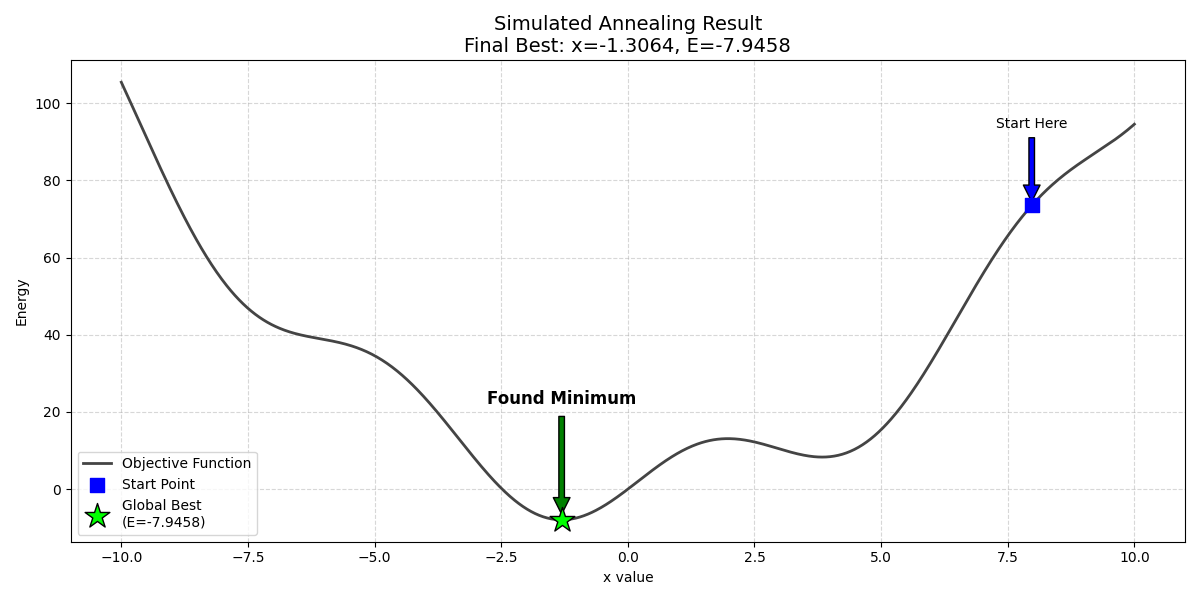
当我们面对非凸、离散、甚至没有梯度的NP-Hard问题时,微积分失效了。这时,我们向物理学家求助。
5.1 热力学与玻尔兹曼分布
模拟退火(Simulated Annealing, SA)的灵感来源于金属冶炼中的退火过程。当金属缓慢冷却时,原子有足够的时间重新排列,最终形成能量最低的晶体结构。
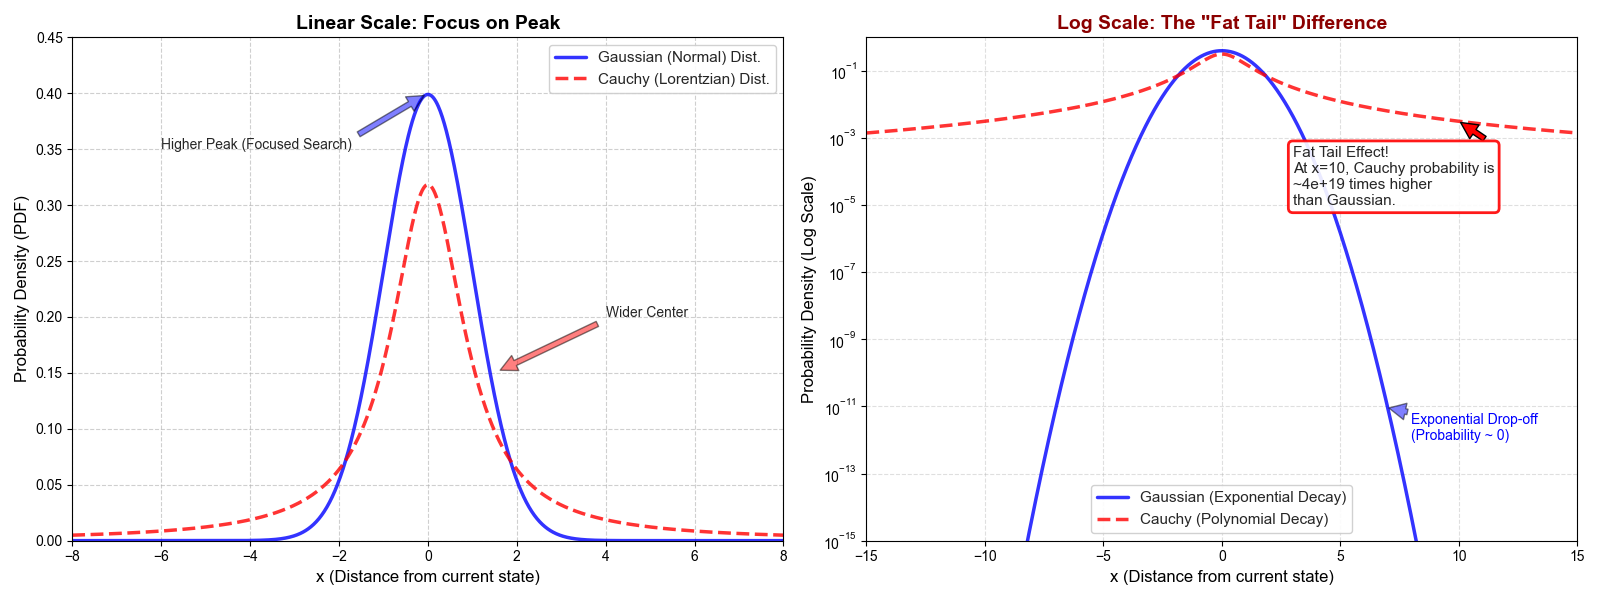
在算法中,我们接受一个“更差的解”的概率遵循玻尔兹曼分布(Boltzmann Distribution):
其中 \(\Delta E\) 是目标函数(能量)的增加量,\(T\) 是温度。
5.2 熵与探索
- 高温 (\(T \to \infty\)):\(P \approx 1\)。算法表现为随机游走(Random Walk)。这是**探索(Exploration)**阶段,能够跳出局部最优的陷阱。
- 低温 (\(T \to 0\)):\(P \to 0\)(如果 \(\Delta E > 0\))。算法表现为贪心搜索(Greedy Search)。这是**开发(Exploitation)**阶段,精细打磨解的质量。
模拟退火本质上是在利用**熵(Entropy)**的力量来对抗局部极小值。它证明了:有时候,为了得到最好的结果,你必须允许暂时的倒退。这是一个极具哲学意味的算法。
import math
import random

def simulated_annealing(objective_func, initial_temp, cooling_rate):
    """
    模拟退火算法核心逻辑
    """
    current_sol = random_start()
    current_energy = objective_func(current_sol)
    temp = initial_temp

    while temp > 1:
        new_sol = get_neighbor(current_sol)
        new_energy = objective_func(new_sol)

        # Metropolis 准则
        if new_energy < current_energy:
            current_sol = new_sol
            current_energy = new_energy
        else:
            prob = math.exp((current_energy - new_energy) / temp)
            if random.random() < prob:
                current_sol = new_sol
                current_energy = new_energy

        temp *= cooling_rate  # 降温
六、 单纯形法:几何学的巅峰 (The Simplex Method)
在线性规划(Linear Programming, LP)领域,乔治·丹齐格(George Dantzig)提出的单纯形法是永恒的经典。
虽然它在最坏情况下的时间复杂度是指数级的,但在实际应用中,它快得惊人。为什么?
6.1 多胞体的顶点
线性规划的可行域是一个高维空间中的凸多胞体(Polytope)。线性函数的极值一定取在多胞体的**顶点(Vertex)**上。
单纯形法的本质,就是沿着多胞体的棱(Edge),从一个顶点跳到相邻的另一个目标函数值更优的顶点。
6.2 为什么值得学?
尽管内点法(Interior Point Methods)在理论复杂度上更优,但单纯形法教会了我们如何利用**基(Basis)**变换来遍历解空间。它连接了组合数学、几何学和线性代数。理解单纯形法,你就理解了资源分配问题的核心。
结语:算法的统一性
回望这些经典算法,我们会发现它们并非孤立存在:
- 牛顿法利用了二阶几何结构。
- 共轭梯度利用了线性代数的正交性。
- 拉格朗日乘数利用了经济学的对偶性。
- 模拟退火利用了热力学的统计规律。
作为一名技术人员,学习这些算法不仅是为了“调包”,更是为了培养一种跨学科的建模直觉。当你面对一个新的工程问题时,你会思考:这个系统的“能量”是什么?它的“约束”在哪里?我是应该利用“梯度”快速下降,还是利用“温度”跳出陷阱?
这就是经典算法的力量——它们不仅是工具,更是理解世界的思维模型。
CONTINUE EXPLORING
DISCUSSION
留言与讨论
分享你的理解,或留下一个值得继续讨论的问题。
还没有留言,欢迎成为第一个参与讨论的人。