
计算机与人工智能
从信息熵到决策边界:决策树算法的第一性原理与深度解析
文章目录
在机器学习的浩瀚星空中,决策树(Decision Tree)或许不是最耀眼的那个(相比于深度神经网络),但它绝对是最接近人类认知逻辑的模型。
当我们试图向一个非技术人员解释模型是如何做出判断时,神经网络的黑盒特性往往让人无言以对,而决策树却能通过清晰的“若-则”(If-Then)规则展示其逻辑链条。然而,这种直观性往往掩盖了其背后深刻的数学原理和算法设计哲学。
本文将剥离表层的应用技巧,从第一性原理出发,探讨决策树是如何利用信息论来量化不确定性,并通过递归的方式构建出一套能够拟合复杂数据分布的逻辑结构。
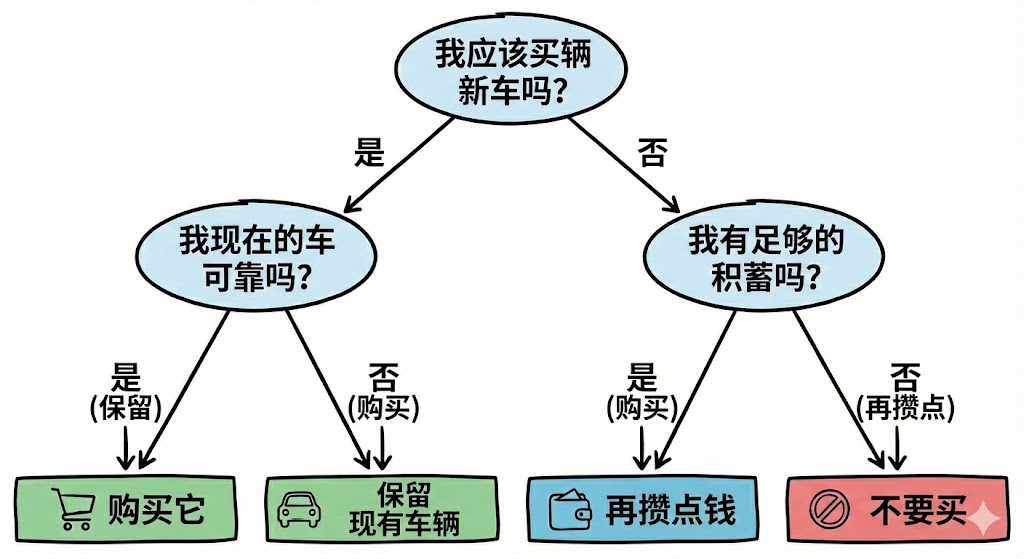
1. 认知的本质:从“二十个问题”游戏说起
在进入数学公式之前,我们先回顾一个经典的智力游戏——“二十个问题”。
在这个游戏中,出题者心里想一个物体,猜题者可以通过提问来缩小范围,但出题者只能回答“是”或“否”。 * 低效的提问:“它是苹果吗?”(如果是,游戏结束;如果不是,排除的范围极小) * 高效的提问:“它是有生命的吗?”(无论回答是或否,都能将搜索空间大约缩小一半)
决策树的学习过程,本质上就是机器在玩这个游戏。算法的核心目标,就是寻找那些能够最大程度减少“不确定性”的问题(特征划分)。
在计算机科学中,这种通过一系列判断来分割数据空间的方法,被称为分治策略(Divide and Conquer)。而决策树正是这种策略在统计学习领域的完美体现。
2. 第一性原理:如何量化“不确定性”?
要让机器自动选择“最好的问题”,我们必须量化“不确定性”。这里我们需要引入物理学和信息论的基石概念:熵(Entropy)。
2.1 热力学与信息论的交汇
19世纪,路德维希·玻尔兹曼(Ludwig Boltzmann)将熵定义为系统的无序程度。1948年,克劳德·香农(Claude Shannon)将这一概念引入信息论,用来衡量随机变量的不确定性。
对于一个取有限个值的离散随机变量 \(X\),其概率分布为 \(P(X=x_i) = p_i\),则 \(X\) 的信息熵 \(H(X)\) 定义为:
第一性原理思考: * 为什么是负号?因为 \(\log p_i\) 在 \(p_i \in (0, 1]\) 时为负,加负号使熵为正值。 * 为什么是对数?因为信息是可加的(两个独立事件的信息量应为两者之和),而概率是相乘的,对数函数将乘法转换为加法。 * 直观理解:如果一个集合里的样本全部属于同一类别(\(p=1\)),则 \(\log 1 = 0\),熵为 0(完全确定)。如果样本均匀分布在各类中(\(p=1/n\)),熵最大(最混乱,最不确定)。
2.2 基尼不纯度(Gini Impurity)
除了熵,另一个衡量集合纯度的指标是基尼不纯度。它源于经济学中衡量收入不平等的基尼系数。在分类问题中,它是指从数据集中随机选取两个样本,其类别不一致的概率。
虽然熵和基尼系数在数学形式上不同,但在二分类问题的图像上,它们的形状非常相似(都是在 \(p=0.5\) 处取最大值的抛物线形状)。在实际应用中,CART 算法倾向于使用基尼系数,因为它不涉及对数运算,计算效率略高。
3. 算法演进:从 ID3 到 CART
理解了量化指标,我们来看看历史上三个里程碑式的算法是如何利用这些指标来构建树的。
3.1 ID3:信息增益(Information Gain)
ID3(Iterative Dichotomiser 3)由 Ross Quinlan 在 1986 年提出。它的核心思想是:选择那个能让数据子集熵下降最快的特征进行分裂。
我们将分裂前的数据集为 \(D\),分裂后的特征为 \(A\)。特征 \(A\) 对数据集 \(D\) 的信息增益 \(g(D, A)\) 定义为:
其中 \(H(D|A)\) 是条件熵,表示在已知特征 \(A\) 的情况下,数据集 \(D\) 的不确定性。
这里 \(V\) 是特征 \(A\) 的可能取值个数。
ID3 的缺陷: ID3 倾向于选择取值较多的特征。试想,如果把“身份证号”作为一个特征,每个样本的身份证号都不同,分裂后的纯度极高(熵为0),信息增益最大。但这种分裂毫无泛化能力,纯属过拟合。
3.2 C4.5:信息增益比(Gain Ratio)
为了修正 ID3 的偏好,Quinlan 提出了 C4.5。它引入了**分裂信息(Split Information)**项作为分母,以此来惩罚取值过多的特征。
其中 \(H_A(D) = - \sum_{v=1}^{V} \frac{|D^v|}{|D|} \log_2 \frac{|D^v|}{|D|}\) 是特征 \(A\) 本身的熵。如果特征取值很多, \(H_A(D)\) 会很大,从而抑制了信息增益比。
3.3 CART:分类与回归树
CART(Classification and Regression Tree)是目前应用最广泛的决策树算法。与 ID3/C4.5 不同,CART 假设决策树是二叉树,其核心差异在于:
- 分类树:使用基尼系数最小化原则。
- 回归树:由于目标变量是连续值,无法计算熵。CART 使用平方误差最小化准则。
对于回归树,我们寻找切分点 \(s\) 和特征 \(j\),使得划分后的两个区域 \(R_1, R_2\) 的平方误差之和最小:
其中 \(c_1, c_2\) 分别是两个区域内输出值的均值。这本质上是在寻找一个分段常数函数来拟合曲线。
4. 树的生长与剪枝:偏差与方差的博弈
决策树是一种非参数模型,如果不加限制,它会试图去拟合训练数据中的每一个噪声点,导致树生长得非常深。
- 深树:低偏差(Bias),高方差(Variance),极易过拟合。
- 浅树:高偏差,低方差,容易欠拟合。
为了找到平衡点,我们必须进行剪枝(Pruning)。
4.1 预剪枝(Pre-Pruning)
在树构建过程中提前停止。常用的超参数包括:
* max_depth: 树的最大深度。
* min_samples_split: 节点分裂所需的最小样本数。
* min_impurity_decrease: 如果分裂带来的纯度提升不足该阈值,则停止。
预剪枝简单高效,但面临“视界效应”:当前看起来微不足道的分裂,也许是后续某个强力分裂的前置条件。预剪枝可能导致欠拟合。
4.2 后剪枝(Post-Pruning)
先让树充分生长,直到过拟合,然后自底向上地修剪掉对泛化性能没有贡献的子树。
最著名的策略是代价复杂度剪枝(Cost-Complexity Pruning, CCP)。我们需要最小化以下损失函数:
- \(C(T)\):树 \(T\) 在训练集上的预测误差(如基尼系数或平方误差)。
- \(|T|\):树的叶节点个数(代表模型复杂度)。
- \(\alpha \ge 0\):正则化参数,权衡拟合程度与复杂度。
当 \(\alpha\) 增大时,我们被迫选择更简单的树。这与线性回归中的 Lasso/Ridge 正则化有着异曲同工之妙。
5. 深入代码层面:Python 实现
理论必须落地。虽然 Scikit-Learn 提供了完善的实现,但理解其接口背后的逻辑至关重要。
from sklearn.datasets import load_iris
from sklearn.tree import DecisionTreeClassifier, export_text
from sklearn.model_selection import train_test_split

# 1. 加载数据:经典的鸢尾花数据集
iris = load_iris()
X, y = iris.data, iris.target

# 2. 划分训练集与测试集
# 保持数据的独立分布是评估模型的关键
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 3. 初始化模型(使用 CART 算法)
# ccp_alpha 参数用于后剪枝,这里演示预剪枝参数 max_depth
clf = DecisionTreeClassifier(
    criterion='gini',    # 使用基尼不纯度
    max_depth=3,         # 预剪枝:最大深度限制
    min_samples_leaf=5,  # 预剪枝:叶节点最小样本数
    random_state=42
)

# 4. 训练模型:递归划分特征空间
clf.fit(X_train, y_train)

# 5. 可视化规则
tree_rules = export_text(clf, feature_names=iris.feature_names)
print("决策树规则结构:")
print(tree_rules)

# 6. 评估
accuracy = clf.score(X_test, y_test)
print(f"测试集准确率: {accuracy:.4f}")
在生产环境中,这段代码背后发生的是:矩阵运算计算每个特征的分割点 -> 贪心搜索最优分割 -> 递归构建对象 -> 存储规则。
6. 决策树的局限性与集成学习的诞生
尽管决策树解释性极强,但它有几个致命弱点:
- 不稳定性(Instability):数据中微小的变化可能导致完全不同的树结构(蝴蝶效应)。这是因为贪心算法在根节点的微小偏差会逐层放大。
- 正交决策边界:决策树的分类边界由垂直于坐标轴的直线组成。处理倾斜的线性关系(如 \(y = x\))时,需要极其复杂的阶梯状结构来逼近,效率极低。
为了解决这些问题,历史的车轮滚滚向前,催生了集成学习(Ensemble Learning):
- Bagging (Random Forest):通过自助采样(Bootstrap)训练多棵树,并行计算,取平均或投票。这主要降低了模型的方差,解决了不稳定性问题。
- Boosting (Gradient Boosting, XGBoost):串行训练,每一棵树都在修正前一棵树的错误(拟合残差)。这主要降低了模型的偏差。
7. 结语
决策树是连接人类逻辑与机器计算的桥梁。从信息熵的物理意义,到基尼系数的经济学渊源,再到递归划分的计算机算法设计,它融合了多学科的智慧。
理解决策树,不仅仅是掌握一个分类器,更是理解机器学习中特征选择、过拟合、正则化以及偏差-方差权衡的最佳切入点。即使在深度学习大行其道的今天,基于树的梯度提升模型(如 XGBoost, LightGBM)在结构化表格数据(Tabular Data)处理上依然占据着统治地位。
掌握了树,你就掌握了通往高级集成模型的钥匙。
参考文献 1. Shannon, C. E. (1948). A Mathematical Theory of Communication. 2. Breiman, L., Friedman, J. H., Olshen, R. A., & Stone, C. J. (1984). Classification and regression trees. 3. Quinlan, J. R. (1986). Induction of decision trees. Machine learning.
CONTINUE EXPLORING
DISCUSSION
留言与讨论
分享你的理解,或留下一个值得继续讨论的问题。
还没有留言,欢迎成为第一个参与讨论的人。