
光学与光子学
超表面光学神经网络
文章目录
引言
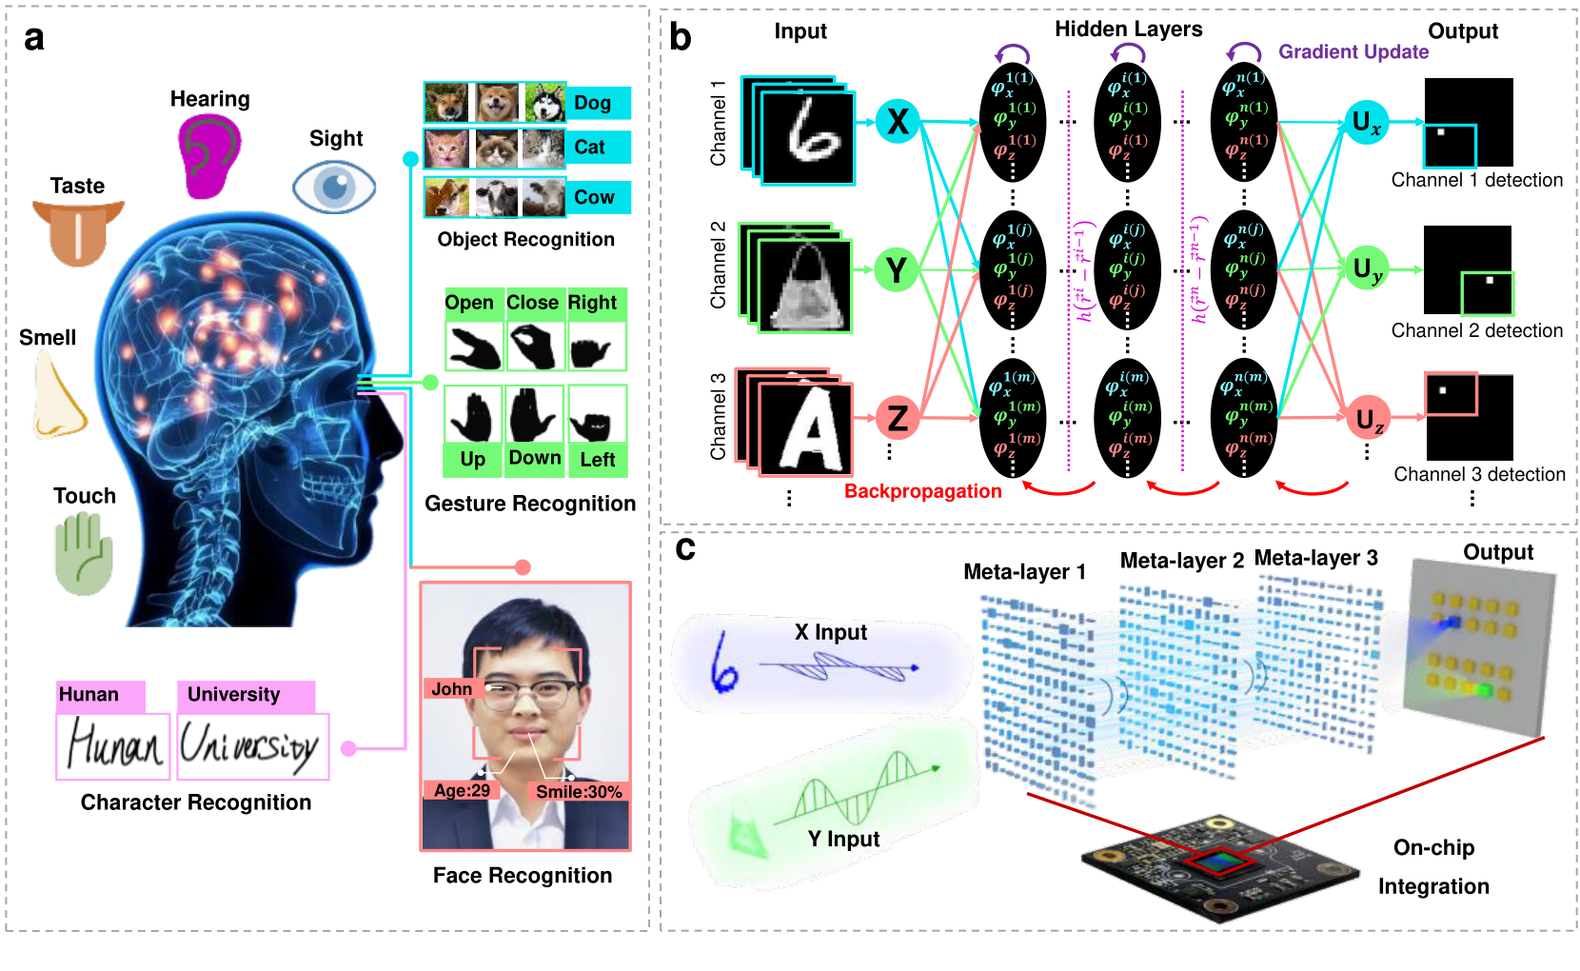
2026年,超表面光学神经网络(Metasurface Optical Neural Networks, MONNs)正站在光学计算与人工智能交汇的最前沿。当传统电子神经网络在摩尔定律放缓和冯·诺依曼瓶颈面前步履维艰时,光子以其固有的超高速、大带宽、低串扰和极低功耗特性,为神经网络的硬件实现开辟了一条全新的赛道。特别是基于超表面的光学神经网络,通过在亚波长尺度上精确调控光的相位、振幅和偏振,将原本需要庞大光学元件阵列才能实现的复杂计算,压缩到一张薄如蝉翼的二维平面内。近日,Nature 及其子刊连续发表多项突破性研究,从边缘视觉处理的超表面原型到具有稳定可编程增益的时间合成光学神经网络,昭示着这一领域正从概念验证迈向实用化部署。本文将深入探讨超表面光学神经网络的核心物理机制、数学原理与前沿进展。
核心概念
1. 超表面与广义斯涅尔定律
超表面(Metasurface)是由亚波长尺度的电磁谐振单元(meta-atoms)在二维平面上周期性或非周期性排列构成的人工电磁材料。与传统体块光学元件依赖光在传播路径上的累积相位不同,超表面通过局域相位突变实现对光波前的灵活调控。这一物理图像由广义斯涅尔定律(Generalized Snell's Law)精确描述:
其中 \(n_i\) 和 \(n_t\) 分别是入射侧和透射侧的折射率,\(\theta_i\) 和 \(\theta_t\) 是入射角和折射角,\(\lambda_0\) 是真空波长,\(d\Phi/dx\) 是沿界面的相位梯度。当 \(d\Phi/dx\) 为常数时,可实现传统的线性相位梯度偏折;当 \(d\Phi/dx\) 为空间坐标的任意函数时,则可实现透镜、涡旋光束生成、全息显示等复杂光学功能。在光学神经网络中,每一层超表面都可以看作一个可训练的光学权重层,其空间相位分布 \( \Phi(x,y) \) 直接编码了神经网络的权重参数。
2. 衍射深度神经网络(D²NN)
衍射深度神经网络(Diffractive Deep Neural Network, D²NN)是超表面光学神经网络的一种重要实现形式。其核心思想是将神经网络的前向传播映射到光在多层衍射结构中的物理传播过程。每一层衍射元件(可以是无源超表面或3D打印的相位掩模)对入射光场进行调制,而光在自由空间中的菲涅尔衍射则天然实现了层与层之间的连接。一个 \(L\) 层的 D²NN 的场传播可以用以下公式描述:
其中 \(U_l(x,y)\) 是第 \(l\) 层的复振幅场,\(t_l(x,y) = e^{i\phi_l(x,y)}\) 是第 \(l\) 层的透射函数(相位调制),\(H_l(f_x, f_y)\) 是自由空间传递函数:
这里 \(z_l\) 是第 \(l\) 层与第 \(l+1\) 层之间的传播距离,\(f_x\) 和 \(f_y\) 是空间频率。通过误差反向传播算法优化每一层的相位分布 \(\phi_l(x,y)\),D²NN 可以学习执行图像分类、目标识别等复杂任务,且整个推理过程在光速量级完成,无需任何数字计算。
3. 时间合成光学神经网络与可编程增益
传统光学神经网络的一个根本性限制在于其计算核心通常是无源的,只能实现能量守恒的酉变换或能量耗散的收缩变换。对于深层网络,累积损耗会迅速降低信噪比,使输出被热噪声和探测器噪声淹没。2026年发表于 Nature Communications 的一项重要工作提出了时间合成光学神经网络(Time-Synthetic Optical Neural Network),通过将可编程增益集成到时间合成维度而非空间光子网格中,巧妙地解决了这一矛盾。
该架构利用一对长度略有差异的耦合光学环路,构建了一个二维时间合成晶格。光脉冲在环路中每循环一次经历动态编程的增益、损耗和相移。由于计算仅在时间的前向方向进行,这种因果性天然抑制了增益引起的反馈不稳定性。脉冲动力学服从修正的离散量子行走方程:
其中 \(u_m^n\) 和 \(v_m^n\) 分别表示短环和长环中第 \(m\) 个时间槽、第 \(n\) 层的复振幅,\(\beta\) 是分束比,\(G \in [e^{-0.3}, e^{0.3}]\) 是可编程增益,\(\varphi\) 是相移。通过这种方式,网络深度由循环次数而非物理元件数量决定,单个紧凑单元即可等效数万个光学门,将空间光子处理器的 \(O(N^2)\) 扩展瓶颈转化为 \(O(1)\) 的物理尺寸。
数学原理
超表面相位调制与角谱理论
从更严格的电磁学角度看,超表面光学神经网络的场分析可以基于角谱理论(Angular Spectrum Method, ASM)展开。设入射平面为 \(z=0\),出射平面为 \(z=z_0\),则传播过程可以写为:
其中 \(\tilde{U}_0(f_x, f_y)\) 是入射场的空间频谱,\(t(f_x, f_y)\) 是超表面的频率域响应(对于薄超表面近似为与频率无关的相位调制),\(H(f_x, f_y; z_0)\) 是前述自由空间传递函数。当传播距离满足近轴近似 \(z_0 \gg \lambda\) 时,传递函数可简化为:
这正是菲涅尔衍射的数学表述。在神经网络训练过程中,通过计算输出场与目标之间的损失函数梯度,并反向传播到每一层的相位参数,即可实现对超表面结构的端到端优化。
光学矩阵乘法与光子加速器
光学神经网络的核心计算任务之一是矩阵-向量乘法。在集成光子平台中,这一运算可以通过马赫-曾德尔干涉仪(MZI)网格或微环谐振器阵列实现。对于超表面平台,空间光调制天然具有大规模并行性。考虑一个 \(N \times N\) 像素的输入图像,每个像素的光场振幅 \(x_{ij}\) 经过超表面层调制后,与相邻像素的光场通过衍射自然耦合,等效于一个稀疏连接的卷积操作:
其中卷积核 \(w_{mn}\) 由超表面相位分布和菲涅尔衍射权重共同决定。在多层堆叠结构中,这种级联的线性变换与非线性光学响应(如饱和吸收或二次谐波产生)相结合,可以逼近任意复杂函数映射,实现与数字深度神经网络等效的表达能力。
应用场景
边缘智能视觉感知
2026年6月发表于 Nature 的一项重要突破展示了一种面向边缘设备的通用视觉处理超表面系统。研究团队将核心计算机视觉操作(如边缘检测、方向梯度提取、空间频率滤波)的基本原理嵌入到大规模光学超表面中,使图像传感器本身即具备感知与处理的复合能力。这种"感算一体"架构的革命性意义在于:传统视觉系统需要先将光信号转换为电信号,再由数字处理器进行计算,而光学超表面直接在光域完成特征提取,仅在最终输出环节进行光电转换。原型系统在多个视觉任务上实现了准确、实时的感知,且参数量仅为传统数字模型的极小比例,为低功耗、高速度的端侧智能提供了全新解决方案。
光学计算加速与量子-经典混合架构
除了直接的视觉推理,超表面光学神经网络还可作为张量计算加速器,为大型人工智能模型提供光学前处理或特征降维能力。在数据中心场景,光子具有 \(10\sim100\) THz 的可用带宽,可在单一超表面芯片上实现每秒数万亿次运算(TOPS),而功耗仅为瓦特级,比数字电子加速器能效高出数个数量级。未来,将光学神经网络与超导量子处理器或光量子计算模块结合,还可能催生全新的量子-经典混合计算架构,在优化问题、分子模拟和生成式AI等领域发挥独特优势。
代码实现
以下是一个基于 Python 的简化衍射光学神经网络模拟示例,演示了如何利用角谱理论实现两层超表面光学网络对 MNIST 手写数字的特征提取:
import numpy as np
import matplotlib.pyplot as plt
from scipy.fft import fft2, ifft2, fftshift, ifftshift

class DiffractiveOpticalLayer:
    """
    单层衍射光学网络层
    基于角谱理论(Angular Spectrum Method)实现光场传播
    """

    def __init__(self, size, wavelength=633e-9, pixel_size=1e-6, distance=0.05):
        """
        初始化衍射层参数

        Parameters:
        -----------
        size : int
            空间采样网格尺寸 (size x size)
        wavelength : float
            光波长 (默认 633 nm, He-Ne激光)
        pixel_size : float
            空间采样间距 (默认 1 μm)
        distance : float
            传播距离 (默认 5 cm)
        """
        self.size = size
        self.wavelength = wavelength
        self.pixel_size = pixel_size
        self.distance = distance

        # 初始化可训练的相位分布 (0 ~ 2π)
        self.phase = np.random.rand(size, size) * 2 * np.pi

        # 预计算自由空间传递函数(角谱)
        fx = fftshift(np.fft.fftfreq(size, d=pixel_size))
        fy = fftshift(np.fft.fftfreq(size, d=pixel_size))
        FX, FY = np.meshgrid(fx, fy)

        # 瑞利-索末菲衍射传递函数
        k = 2 * np.pi / wavelength
        H = np.exp(1j * distance * np.sqrt(k**2 - (2*np.pi*FX)**2 - (2*np.pi*FY)**2 + 0j))
        # 滤波倏逝波
        H[np.real(np.sqrt(k**2 - (2*np.pi*FX)**2 - (2*np.pi*FY)**2 + 0j)) == 0] = 0
        self.transfer_function = H

    def forward(self, field):
        """
        前向传播:相位调制 + 角谱传播

        Parameters:
        -----------
        field : ndarray (size, size)
            输入复振幅场

        Returns:
        --------
        output : ndarray (size, size)
            输出复振幅场
        """
        # 1. 超表面相位调制
        modulated = field * np.exp(1j * self.phase)

        # 2. 角谱传播:FFT -> 乘以传递函数 -> IFFT
        spectrum = fft2(fftshift(modulated))
        propagated = ifftshift(ifft2(spectrum * self.transfer_function))

        return propagated

    def update_phase(self, gradient, lr=0.1):
        """
        基于梯度更新相位参数(模拟反向传播的一步)

        Parameters:
        -----------
        gradient : ndarray
            损失函数对输出场的梯度
        lr : float
            学习率
        """
        # 简化:直接利用输出梯度对相位进行梯度下降
        # 实际实现中需要完整的反向传播链式法则
        phase_grad = -np.imag(np.conj(gradient) * np.exp(1j * self.phase))
        self.phase -= lr * phase_grad
        self.phase = np.mod(self.phase, 2 * np.pi)


class SimpleDiffractiveNN:
    """
    两层衍射光学神经网络演示
    """

    def __init__(self, size=128):
        self.layer1 = DiffractiveOpticalLayer(size, distance=0.03)
        self.layer2 = DiffractiveOpticalLayer(size, distance=0.03)
        self.size = size

    def forward(self, input_intensity):
        """
        网络前向传播

        Parameters:
        -----------
        input_intensity : ndarray
            输入光强分布 (0~1)

        Returns:
        --------
        output_intensity : ndarray
            输出光强分布
        """
        # 假设输入为相干平面波照射,振幅为输入强度的平方根
        field = np.sqrt(input_intensity + 1e-8)

        # 第一层传播
        field = self.layer1.forward(field)
        # 简化非线性:光强饱和(可替换为真实的材料非线性响应)
        intensity = np.abs(field)**2
        field = np.sqrt(intensity / (1 + 0.1 * intensity)) * np.exp(1j * np.angle(field))

        # 第二层传播
        field = self.layer2.forward(field)
        output_intensity = np.abs(field)**2

        return output_intensity

    def visualize(self, input_pattern):
        """可视化传播过程"""
        fig, axes = plt.subplots(1, 3, figsize=(15, 5))

        # 输入
        axes[0].imshow(input_pattern, cmap='hot')
        axes[0].set_title('Input Intensity')
        axes[0].axis('off')

        # 第一层相位
        axes[1].imshow(self.layer1.phase, cmap='twilight')
        axes[1].set_title('Layer 1 Phase Pattern')
        axes[1].axis('off')

        # 输出
        output = self.forward(input_pattern)
        axes[2].imshow(output, cmap='hot')
        axes[2].set_title('Output Intensity')
        axes[2].axis('off')

        plt.tight_layout()
        plt.show()
        return output


# ===================== 演示 =====================
if __name__ == "__main__":
    size = 128

    # 构建一个简单的 MNIST-like 测试输入(模拟数字"1"的竖线)
    test_input = np.zeros((size, size))
    test_input[:, size//2-4:size//2+4] = 1.0

    # 初始化网络
    net = SimpleDiffractiveNN(size)

    # 执行前向传播并可视化
    output = net.visualize(test_input)

    print(f"输入总能量: {np.sum(test_input):.3f}")
    print(f"输出总能量: {np.sum(output):.3f}")
    print(f"能量效率: {np.sum(output)/np.sum(test_input)*100:.1f}%")

    # 注:完整训练需要定义损失函数、反向传播算法和优化器
    # 本代码仅演示物理传播过程,未包含训练循环
今日动态
-
Nature | 超表面边缘视觉处理取得突破:Peng 等人报道了一种面向通用视觉处理的光学超表面系统,将核心计算机视觉操作嵌入到大规模光学超表面中,实现了准确、低功耗的实时边缘感知。该原型在参数量远小于传统数字模型的情况下,在多个视觉任务上表现优异,为端侧智能部署提供了新范式。阅读原文
-
Nature Communications | 时间合成光学神经网络实现稳定可编程增益:Wu 等人提出了一种基于时间合成维度的光学神经网络新架构,通过一对耦合光学环路将可编程增益集成到时间维度而非空间光子网格。这种因果性设计天然抑制了反馈不稳定性,使深层光学网络的信噪比得以维持,实验在 MNIST 和 CIFAR-10 数据集上展示了鲁棒的推理性能。阅读原文
-
Nature Electronics | 可编程超表面实现时空全息:Gu 等人利用快速收敛相位恢复算法,在具有6144个单元的可编程超表面上实现了62幅全息图像的同时生成。该工作展示了超表面在动态全息显示和光场调控方面的强大潜力,为下一代三维显示和光通信复用技术提供了新思路。阅读原文
总结
超表面光学神经网络正在从学术概念迅速转化为具有实际应用潜力的技术平台。本文梳理了该领域的三大核心支柱:基于广义斯涅尔定律的亚波长相位调控、衍射深度神经网络的物理前向传播框架,以及突破无源限制的时间合成增益架构。数学上,角谱理论为多层超表面网络的场分析提供了严格工具,而菲涅尔衍射的卷积特性与光学矩阵乘法天然契合神经网络计算需求。当前,Nature 系列期刊的密集报道表明,该领域正处于从"实验室到产业化"的关键跃迁期。未来,随着超表面制备工艺的成熟(如CMOS兼容的纳米压印和电子束光刻)、可编程材料(如相变材料Sb₂Se₃和液晶)的集成,以及光电混合训练算法的完善,我们有望在智能手机、自动驾驶、医疗影像和数据中心等场景中看到超表面光学神经网络的广泛应用。光计算的时代,正在加速到来。
CONTINUE EXPLORING


DISCUSSION
留言与讨论
分享你的理解,或留下一个值得继续讨论的问题。
还没有留言,欢迎成为第一个参与讨论的人。