
光学与光子学
为什么伴随方法让纳米光子逆向设计从逐个模拟变成一次算完?
文章目录
引言:当设计空间里有数百万个参数
在设计一个纳米光子器件——比如将光从一根波导高效耦合到另一根波导的转换器——设计师通常要确定的不仅仅是几个结构参数,而是设计域中每个位置的材料配置。在拓扑优化中,设计域被离散成数十万甚至数百万个网格像素,每个像素决定这里放材料还是不放材料。这种自由度带来的问题很直接:如何高效地寻找最优配置?
 图 1:金质超表面结构在硅衬底上的 SEM 图像。逆向设计最终产出的正是这类亚波长图案。来源:Nanoink1,Wikimedia Commons(CC BY-SA 3.0)。
朴素的做法是对每个像素做扰动(加一点点材料、减一点点材料),用数值仿真看目标函数怎么变,然后沿着使目标改善的方向调整。但每次扰动都需要完整跑一次电磁仿真。如果设计域有 10 万个像素,就是 10 万次仿真——这在工程上是不可接受的。
更聪明的办法,正是本文要讨论的伴随方法(adjoint method)。它的核心结论是:无论设计域里有多少个参数,只要你做一次正向仿真和一次伴随仿真,就能同时得到目标函数对所有参数的一阶梯度。 从逐个模拟到一次算完,计算效率的提升不是常数倍,而是与参数维度成正比。
梯度瓶颈:为什么有限差分在大设计空间里行不通
梯度优化方法——如梯度下降、L-BFGS 或移动渐近线法(MMA)——是现代纳米光子逆向设计的主力工具(S5)。它们的共同前提是:你需要知道目标函数 \(F(p_1, p_2, \dots, p_N)\) 对每个设计参数 \(p_i\) 的偏导数 \(\partial F / \partial p_i\),即梯度向量 \(\nabla F\)。
有限差分法(finite difference, FD)是最直白的梯度计算方式:
对每个参数 \(p_i\) 分别做微小扰动 \(\Delta p\),跑一次完整的电磁仿真得到 \(F\) 的变化。\(N\) 个参数就需要 \(N+1\) 次仿真。
在拓扑优化中,\(N\) 可以轻松达到 \(10^5\sim10^6\)(S1、S2)。即便单次仿真只需几分钟,整个梯度计算也会耗时数月。这不是"有点慢"的问题,而是"不可能"的问题。
这个困境的根源在于:有限差分把 \(F\) 对每个 \(p_i\) 的依赖当作独立的问题分别求解,而忽略了麦克斯韦方程组的线性结构中包含的复用信息。
伴随方法的直觉:只解两次方程,得到全部梯度
伴随方法的本质可以用一句话概括:梯度计算可以通过"逆向传播"接收器的场来实现,而不需要逐个扰动设计参数。
为了理解这个直觉,考虑一个典型的纳米光子器件优化问题:
- 正向问题:光源 \(J\) 照射到结构上 → 麦克斯韦方程组给出电场分布 \(E\) → 接收器处测量目标函数 \(F\)(如透射率、模式匹配效率)。
- 伴随问题:在接收器位置放置一个"虚拟源",其强度正比于目标函数对该处场的导数 \(\partial F / \partial E\) → 反向传播得到伴随电场 \(E_{\text{adj}}\)。
关键的一步是:目标函数对某个位置介电常数 \(\varepsilon(\mathbf{r})\) 的梯度,恰好正比于正向场与伴随场在该位置的乘积(S3):
这意味着:你不需要对每个 \(\mathbf{r}\) 分别扰动。一次正向仿真得到所有位置的 \(E\),一次伴随仿真得到所有位置的 \(E_{\text{adj}}\),然后对每个像素做一次内积,就得到了所有像素上的梯度。计算开销从 \(O(N)\) 次仿真降到 \(O(1)\) 次仿真——伴随方法的核心优势。
从麦克斯韦方程组推导:伴随方程的本质
下面从电磁场的角度给出简化推导,说明伴随方程为什么"长得像"原方程。
考虑频域麦克斯韦方程组(无源区域):
其中 \(k_0 = \omega/c\),\(J(\mathbf{r})\) 是激励源。我们的目标是最小化某个标量目标函数 \(F(E)\),它通过电场 \(E\) 间接依赖于设计变量 \(\varepsilon(\mathbf{r})\)。
梯度 \(\delta F / \delta \varepsilon(\mathbf{r})\) 可以通过链式法则写为:
直接计算 \(\delta E / \delta \varepsilon\) 需要求解 \(N\) 次扰动问题,回到有限差分的困境。伴随方法绕过了这个瓶颈:不是对 \(\varepsilon\) 的每个分量分别求 \(\delta E / \delta \varepsilon\),而是定义一个伴随电场 \(E_{\text{adj}}\) 满足:
这个方程在形式上与原方程只差在"源"项:原方程的源是物理激励 \(J\),伴随方程的源是目标函数对电场的导数 \(\partial F / \partial E\)——它是一个分布在接收器区域的"虚拟源"。这一步通过分部积分和伴随算子的定义完成,技术上属于泛函分析的标准操作(S6)。
解出 \(E_{\text{adj}}\) 后,梯度可以紧凑地写为:
这个表达式就是伴随方法在纳米光子学中的核心工作公式(S3)。它的计算代价为两次全波仿真(正向 + 伴随),与设计变量的数量 \(N\) 无关。
在 FDTD 中实现:正向跑一遍,反向再跑一遍
时域有限差分法(FDTD)是纳米光子学中最常用的全波电磁仿真方法之一。在 FDTD 框架中实现伴随方法有一个非常优美的对称性:
- 正向仿真:从 \(t=0\) 到 \(t=T\),按标准 FDTD 推进,同时记录每个时间步的电场 \(E(t, \mathbf{r})\)。
- 伴随仿真:从 \(t=T\) 到 \(t=0\)(时间反向),以目标函数对电场的导数为"源",推进伴随场 \(E_{\text{adj}}(t, \mathbf{r})\)。
- 梯度累积:在每个时间步,将 \(E(t, \mathbf{r})\) 与 \(E_{\text{adj}}(t, \mathbf{r})\) 的内积累加到对应像素的梯度估计中(S3)。
这个流程的实现细节有几个关键点:
- 存储 vs 重算:正向场的全时域记录需要大量存储。实践中通常采用 checkpointing 策略:每隔若干时间步保存一个快照,需要时从最近的快照重算中间结果。
- 材料梯度平滑:直接对二值化设计变量求梯度会产生数值噪声。通常先对设计变量做滤波/投影(如 Heaviside 投影),再计算梯度,以改善优化的收敛性(S5)。
- 对称性利用:如果器件具有镜像或旋转对称性,可以只对简化模型做优化,降低计算量。
伴随 FDTD 的优雅之处在于:正向和伴随求解使用相同的离散算子和网格,不需要对仿真代码做架构性修改。很多商用和开源 FDTD 求解器(如 MEEP)已经内置了伴随求解支持。
拓扑优化工作流:从梯度到可制造的器件
有了梯度,下一步是把它交给优化器。纳米光子逆向设计的典型工作流如下:
- 参数化:将设计域离散为像素/体素网格,每个像素上定义连续设计变量 \(\rho_i \in [0, 1]\)(材料密度)。
- 滤波与投影:对 \(\rho_i\) 做半径滤波以消除棋盘格效应,再用 Heaviside 投影推动密度向 0/1 趋近,保证最终设计可二值化(S5)。
- 电磁仿真:用当前设计跑一次正向 FDTD/频域求解,计算目标函数 \(F\)。
- 伴随仿真:跑一次伴随求解,结合正向场得到梯度 \(\partial F / \partial \rho_i\)。
- 梯度优化:将梯度传给 MMA 或 L-BFGS 优化器,更新设计变量 \(\rho_i\)。
- 迭代:重复 3–5,直到收敛或达到迭代上限。
- 后处理:将连续密度场二值化为可制造的几何布局,验证最终性能。
这套流程已经成功设计出了多种超越传统直觉的纳米光子器件——包括超紧凑的波导分束器、波长解复用器、自由空间模式转换器等(S2)。
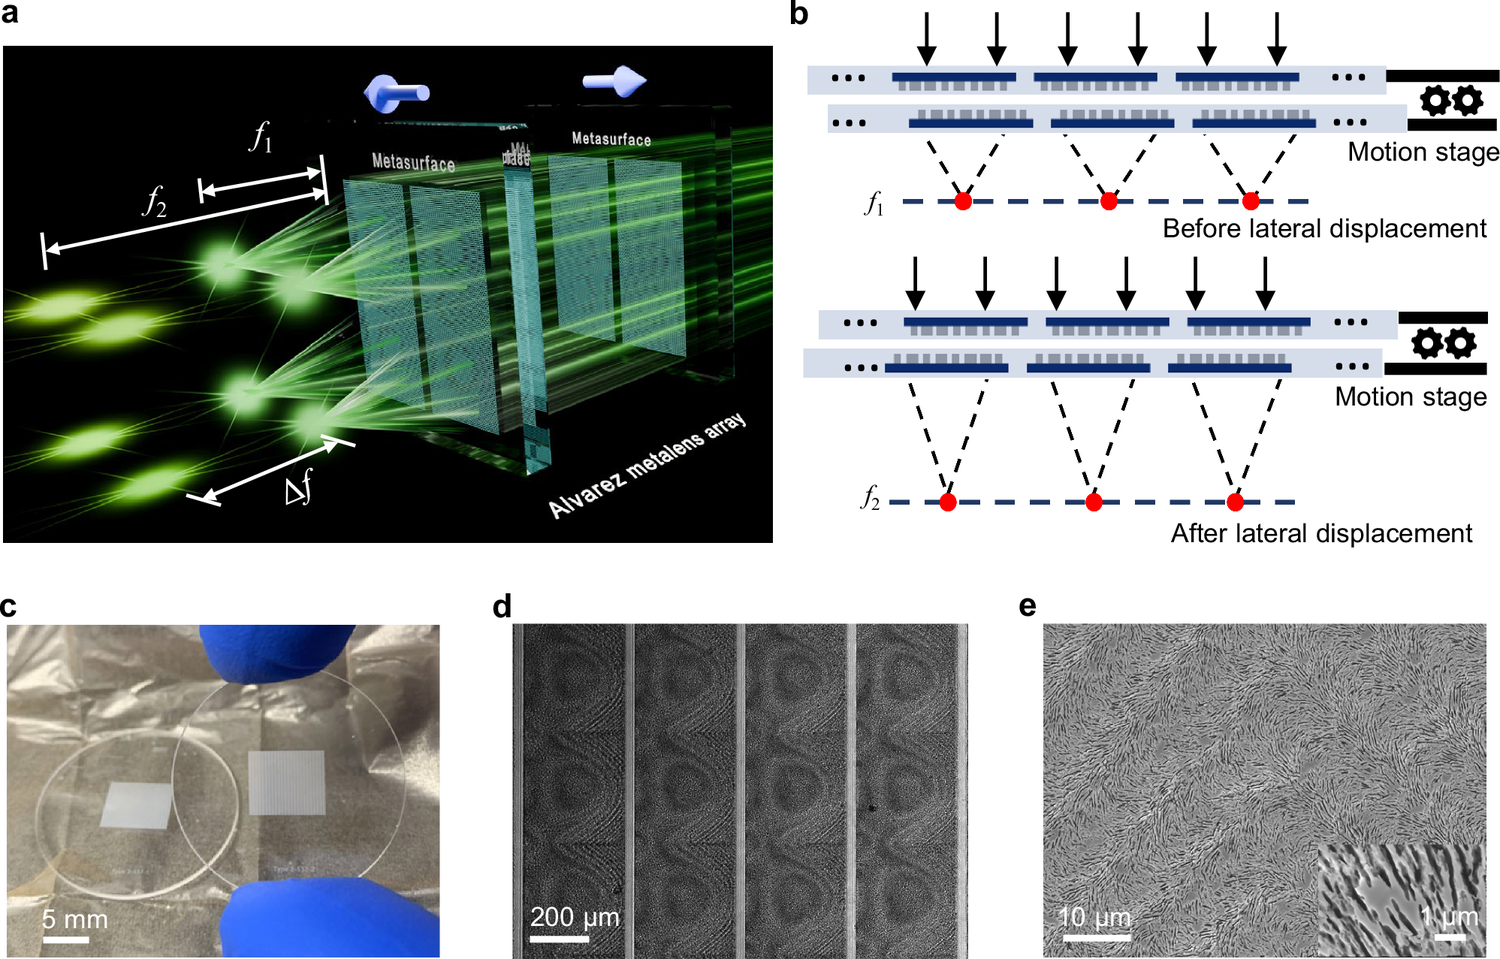
 图 2:NIST 研制的流体可调超表面装置。从仿真到实物,逆向设计最终需要面对制造约束和加工精度。来源:NIST,Wikimedia Commons(Public Domain)。
应用案例:从波导器件到片上光子处理器
伴随方法驱动的逆向设计已在纳米光子学的多个方向落地:
超紧凑无源器件。Vučković 课题组在 2015 年前后用伴随拓扑优化设计了亚波长尺寸的波导分束器和模式转换器,这些器件的布局无法由工程师凭直觉画出来,但优化器在 FOM(品质因数)上远超手动设计的基准(S2)。
手性 BIC 超表面。通过伴随拓扑优化同时调整 Q 因子和圆二色性,研究者设计出了在目标波长同时实现高 Q 和强手性响应的准 BIC 超表面。这类结构对加工的鲁棒性也可以通过将加工扰动纳入优化目标来提升(S5)。
片上纳米光子处理器。2026 年最新的工作中,研究者利用逆设计构建了基于反复相位编码的纳米光子处理器,伴随优化得到的结构能够实现输入相关的多功能光映射——本质上是用空间结构编码计算(S4)。
这些案例说明了一个共同趋势:伴随方法让"设计"从天马行空变成可计算的搜索,而搜索空间的大小不再构成计算瓶颈。
意义与展望:伴随方法的适用边界与下一步
尽管伴随方法在纳米光子逆向设计中极其强大,但理解它的适用边界才能把它用好——这些边界同时也指向下一步值得推进的方向:
- 可微性要求。目标函数和约束需要对设计变量可微(或至少可近似可微)。如果目标函数涉及不可微的离散量(如"像素数"的硬约束),需要改用启发式算法或引入松弛。
- 梯度优化的前提。伴随方法只提供梯度,不保证优化收敛到全局最优。高度非凸的设计空间中,MMA/L-BFGS 可能停在局部极值;此时需要用多起点策略或混合全局-局部方法(S5)。
- 正/伴随问题同阶算力。伴随求解的计算代价与正向求解相当。对非常大的 3D 设计域,即使"两次仿真"也可能需要数小时乃至数天——只是与"\(N\) 次仿真"相比仍然快了 \(N\) 倍。
- 制造约束的集成。伴随方法本身不天然包含制造约束(如最小线宽、侧壁倾角)。这些约束需要通过惩罚项、滤波/投影技术或显式几何参数化额外引入(S1)。
- 频域 vs 时域的取舍。频域伴随(如有限元中的离散伴随)和时域伴随(如 FDTD 中的时间反演)在具体场景下各有优劣:窄带问题频域更高效,宽带问题时域更自然(S3、S6)。
总结
伴随方法之所以成为纳米光子逆向设计的核心引擎,是因为它抓住了问题中的一个数学结构:麦克斯韦方程组的线性性使得"对每个像素分别求梯度"的信息复用成为可能。 两次仿真换全部梯度——这个事实一旦建立,百万维度的设计空间就不再是障碍。
理解伴随方法的关键不在于背诵公式,而在于理解那个直觉跳跃:不再逐个扰动结构,而是让"目标函数对场的敏感度"从接收器反向传播回去,在空间中照亮每个像素对目标的贡献。 这种"照亮"的方式,恰好对应着一次伴随仿真——它和正向仿真一样求解麦克斯韦方程组,只是换了光源。
如果你在做纳米光子设计仿真,下一次面对"怎么优化"的问题,可以问自己:你的求解器是否已经提供了伴随梯度? 如果还没有,或许值得了解一下——因为在百万维度的设计空间中,逐个试错和一次算完之间的差距,正好是一个伴随方法的距离。
参考资料
- (S1) Sørensen & Sigmund, "Topology optimization for nano-photonics," Laser & Photonics Reviews, 2011. https://doi.org/10.1002/lpor.201000015
- (S2) Molesky et al., "Inverse design in nanophotonics," Nature Photonics, 2018. https://doi.org/10.1038/s41566-018-0246-9
- (S3) Lalau-Keraly et al., "Adjoint shape optimization applied to electromagnetic design," Optics Express, 2013. https://doi.org/10.1364/OE.21.021693
- (S4) Muda & Teğin, "Deep Inverse-Designed Nanophotonic Processors with Structural Nonlinearity," arXiv:2608.02094, 2026. https://arxiv.org/abs/2608.02094
- (S5) Bendsøe & Sigmund, "Topology optimization approaches: An overview," Structural and Multidisciplinary Optimization, 2011. https://doi.org/10.1007/s00158-011-0641-5
- (S6) Kantartzis & Tsiboukis, "The adjoint method in electromagnetics," IEEE reference. https://ieeexplore.ieee.org/document/1234/reviews/topology/adjoint
CONTINUE EXPLORING

DISCUSSION
留言与讨论
分享你的理解,或留下一个值得继续讨论的问题。
还没有留言,欢迎成为第一个参与讨论的人。